Seitenaufbau: So funktionieren Browser
Nutzer möchten Webangebote, deren Inhalte schnell laden und die sich flüssig bedienen lassen. Entwickler sollten daher darauf hinarbeiten, diese Ziele zu erreichen.
Wenn Sie Änderungen umsetzen, die die tatsächliche und die wahrgenommene Performance verbessern, ist es hilfreich zu verstehen, wie der Browser funktioniert. Dieser Artikel erklärt, wie der Browser Inhalte lädt und welche Faktoren die Performance beeinflussen.
Überblick
Schnelle Websites bieten eine bessere Nutzererfahrung. Nutzer erwarten, dass Inhalte schnell laden und die Bedienung flüssig und reaktionsschnell ist.
Zwei große Herausforderungen für die Web-Performance sind die Latenz und die Tatsache, dass Browser größtenteils nur einen Thread für die Ausführung verwenden.
Die Latenz ist die größte Hürde auf dem Weg zu schnell ladenden Seiten. Ziel der Entwickler ist es, die Website so schnell wie möglich laden zu lassen – oder sie zumindest scheinbar besonders schnell laden zu lassen –, damit Nutzer die angeforderten Informationen möglichst rasch erhalten. Die Netzwerklatenz ist die Zeit, die benötigt wird, um Bytes über das Netzwerk an Computer zu übertragen. Bei der Web-Performance geht es darum, die Ladezeit einer Seite so weit wie möglich zu verkürzen.
Browser gelten größtenteils als single-threaded. Das heißt, sie führen eine Aufgabe von Anfang bis Ende aus, bevor sie die nächste beginnen. Entwickler müssen für performante Interaktionen mit der Website sorgen – vom flüssigen Scrollen bis hin zu reaktionsschnellen Touch-Interaktionen. Die Renderzeit ist dabei entscheidend: Der Hauptthread muss alle Aufgaben erledigen, die wir ihm übertragen, und trotzdem für Nutzerinteraktionen verfügbar bleiben. Die Web-Performance lässt sich verbessern, wenn Sie die Single-Thread-Natur des Browsers berücksichtigen und die Aufgaben des Hauptthreads auf ein Minimum reduzieren. So können Inhalte flüssig gerendert und Eingaben unmittelbar beantwortet werden.
Navigation
Die Navigation ist der erste Schritt beim Laden einer Webseite. Sie beginnt, wenn ein Nutzer eine Seite anfordert, etwa indem er eine URL in die Adressleiste eingibt, auf einen Link klickt oder ein Formular absendet.
Ein Ziel der Web-Performance ist es, die Dauer bis zum Abschluss der Navigation zu minimieren. Latenz und Bandbreite können dabei zu Verzögerungen führen.
DNS-Abfrage
Der erste Schritt beim Aufrufen einer Webseite besteht darin, die Ressourcen der Seite zu finden. Wenn Sie https://example.com aufrufen, liegt die HTML-Seite auf einem Server mit der IP-Adresse 93.184.216.34. Beim ersten Besuch dieser Website findet eine DNS-Abfrage statt.
Ihr Browser fordert eine DNS-Abfrage an, die schließlich von einem Nameserver beantwortet wird. Dieser liefert eine IP-Adresse zurück. Nach dieser ersten Anfrage wird die IP-Adresse wahrscheinlich zwischengespeichert. Das beschleunigt spätere Anfragen, da die IP-Adresse aus dem Cache statt vom Nameserver abgerufen werden kann.
Eine DNS-Abfrage ist beim Laden einer Seite in der Regel nur einmal pro Hostname erforderlich. Für jeden eindeutigen Hostnamen, auf den die angeforderte Seite verweist, muss jedoch eine eigene DNS-Abfrage stattfinden. Wenn Ihre Schriftarten, Bilder, Skripte, Anzeigen und Metriken jeweils unterschiedliche Hostnamen haben, ist für jeden davon eine DNS-Abfrage nötig.
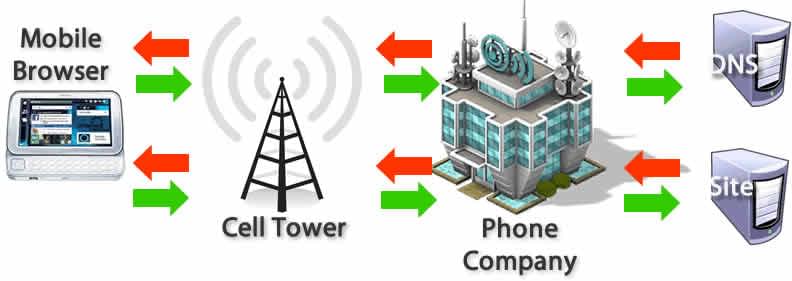
Das kann besonders in Mobilfunknetzen die Performance beeinträchtigen. Wenn ein Nutzer ein Mobilfunknetz verwendet, führt jede DNS-Abfrage vom Telefon über den Mobilfunkmast zu einem autoritativen DNS-Server. Die Entfernung zwischen Telefon, Mobilfunkmast und Nameserver kann die Latenz erheblich erhöhen.
TCP-Handshake
Sobald die IP-Adresse bekannt ist, stellt der Browser über einen dreistufigen TCP-Handshake eine Verbindung zum Server her. Dieser Mechanismus ermöglicht es zwei Kommunikationspartnern – hier dem Browser und dem Webserver –, die Parameter der TCP-Socket-Verbindung auszuhandeln, bevor Daten übertragen werden, häufig über HTTPS.
Der dreistufige TCP-Handshake wird oft als „SYN-SYN-ACK“ bezeichnet – genauer gesagt als SYN, SYN-ACK, ACK. TCP überträgt diese drei Nachrichten, um eine TCP-Sitzung zwischen zwei Computern auszuhandeln und zu starten, noch bevor die eigentliche Anfrage gestellt wird.
TLS-Aushandlung
Für sichere Verbindungen über HTTPS ist ein weiterer „Handshake“ erforderlich. Bei diesem Handshake, genauer gesagt bei der TLS-Aushandlung, wird festgelegt, welches Verschlüsselungsverfahren für die Kommunikation verwendet wird. Außerdem wird der Server überprüft und eine sichere Verbindung hergestellt, bevor die Datenübertragung beginnt. Dafür sind fünf weitere Umläufe zum Server erforderlich, bevor die Anfrage nach dem Inhalt gesendet wird.
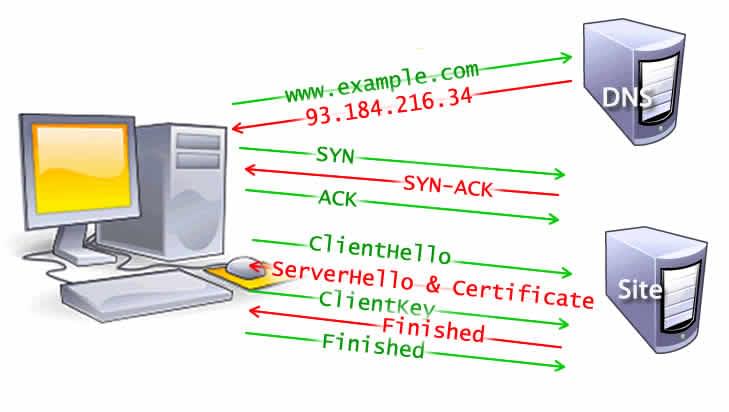
Die Absicherung der Verbindung verlängert die Ladezeit der Seite. Diese zusätzliche Latenz lohnt sich jedoch, da Dritte die zwischen Browser und Webserver übertragenen Daten nicht entschlüsseln können.
Nach acht Umläufen zum Server kann der Browser schließlich die Anfrage stellen.
Antwort
Sobald eine Verbindung zum Webserver besteht, sendet der Browser im Namen des Nutzers eine erste HTTP-GET-Anfrage. Bei Websites richtet sich diese meist auf eine HTML-Datei. Wenn der Server die Anfrage erhält, antwortet er mit den entsprechenden Antwort-Headern und dem HTML-Inhalt.
<!doctype html>
<html lang="en-US">
  <head>
    <meta charset="UTF-8" />
    <title>My simple page</title>
    <link rel="stylesheet" href="styles.css" />
    <script src="myscript.js"></script>
  </head>
  <body>
    <h1 class="heading">My Page</h1>
    <p>A paragraph with a <a href="https://example.com/about">link</a></p>
    <div>
      <img src="my-image.jpg" alt="image description" />
    </div>
    <script src="another-script.js"></script>
  </body>
</html>
Die Antwort auf diese erste Anfrage enthält das erste empfangene Datenbyte. Die Time to First Byte (TTFB) bezeichnet die Zeitspanne zwischen der Anfrage des Nutzers – beispielsweise durch einen Klick auf einen Link – und dem Empfang dieses ersten HTML-Pakets. Der erste Teil der Antwort umfasst üblicherweise 14 KB Daten.
In unserem obigen Beispiel ist die Anfrage deutlich kleiner als 14 KB. Die verlinkten Ressourcen werden jedoch erst angefordert, wenn der Browser beim Parsen auf die Links stößt, wie weiter unten beschrieben.
Überlastungssteuerung / TCP Slow Start
TCP teilt Daten für die Übertragung in Segmente auf und gewährleistet, dass alle Segmente zuverlässig zwischen Server und Client zugestellt werden. Der Client bestätigt empfangene Segmente mit ACK-Paketen. Der Server entscheidet, wie viele Segmente er sendet, bevor er auf eine solche Bestätigung wartet.
Diese Anzahl muss ausgewogen sein: Wartet der Server nach jedem Segment auf ein ACK, verläuft die Übertragung langsam, weil er für jedes gesendete Segment einen vollständigen Umlauf abwarten muss – selbst in einem wenig ausgelasteten Netzwerk. Werden andererseits zu viele Segmente gleichzeitig in ein stark ausgelastetes Netzwerk gesendet, können einige davon unterwegs verloren gehen. Der Client kann Segmente, die er nie empfangen hat, nicht bestätigen; der Server sendet sie daher schließlich erneut.
TCP verwendet zwei voneinander unabhängige Grenzen für die Menge unbestätigter Daten, die der Server gleichzeitig übertragen kann:
- Das Empfangsfenster (RWND) schützt den Client: Es teilt dem Server mit, wie viele eingehende Daten der Client derzeit aufnehmen kann. Diese Grenze hängt vom verfügbaren Platz im Empfangspuffer des Clients ab. Der Client gibt sie dem Server bekannt, um den TCP-Datenfluss zu steuern.
- Das Überlastungsfenster (CWND) schützt das Netzwerk: Es entspricht der Einschätzung des Servers, wie viele Daten der Übertragungsweg zum Client aufnehmen kann, ohne dass Segmente verloren gehen.
Der Server überträgt nie mehr unbestätigte Daten gleichzeitig, als das kleinere dieser beiden Fenster zulässt.
Das Überlastungsfenster ist anfangs klein und wird im Verlauf der Übertragung angepasst. Während des TCP Slow Start wächst es schnell und verdoppelt sich ungefähr bei jedem Umlauf, bis Segmente verloren gehen oder der TCP-Slow-Start-Schwellenwert (ssthresh) erreicht wird. Danach wächst es langsamer und wird reduziert, sobald das Netzwerk Anzeichen einer Überlastung zeigt. Weitere Einzelheiten zur TCP-Überlastungssteuerung finden Sie in RFC 5681.
Parsing
Sobald der Browser den ersten Teil der Daten erhält, kann er beginnen, die empfangenen Informationen zu parsen. Beim Parsing wandelt der Browser die über das Netzwerk empfangenen Daten in das DOM und das CSSOM um. Der Renderer verwendet diese Strukturen, um die Seite auf dem Bildschirm darzustellen.
Das DOM ist die interne Darstellung des Markups im Browser. Es ist außerdem zugänglich und kann über verschiedene JavaScript-APIs verändert werden.
Selbst wenn das HTML der angeforderten Seite größer ist als das erste 14-KB-Paket, beginnt der Browser mit dem Parsen und versucht, die Inhalte anhand der bereits verfügbaren Daten zu rendern. Für die Optimierung der Web-Performance ist es daher wichtig, alles, was der Browser für den Beginn des Renderings benötigt – oder zumindest das HTML- und CSS-Grundgerüst der Seite –, in den ersten 14 KB unterzubringen. Bevor jedoch etwas auf dem Bildschirm dargestellt werden kann, müssen HTML, CSS und JavaScript geparst werden.
Aufbau des DOM-Baums
Wir beschreiben fünf Schritte des kritischen Rendering-Pfads.
Der erste Schritt besteht darin, das HTML-Markup zu verarbeiten und den DOM-Baum aufzubauen. Zum HTML-Parsing gehören die Tokenisierung und der Aufbau des Baums. HTML-Tokens umfassen Start- und End-Tags sowie Attributnamen und -werte. Ist das Dokument wohlgeformt, lässt es sich einfach und schnell parsen. Der Parser verarbeitet die tokenisierte Eingabe und baut daraus den Dokumentbaum auf.
Der DOM-Baum beschreibt den Inhalt des Dokuments. Das Element <html> ist das erste Element und der Wurzelknoten des Dokumentbaums. Der Baum bildet die Beziehungen und Hierarchien zwischen den Elementen ab. Elemente innerhalb anderer Elemente sind Kindknoten. Je mehr DOM-Knoten vorhanden sind, desto länger dauert der Aufbau des DOM-Baums.
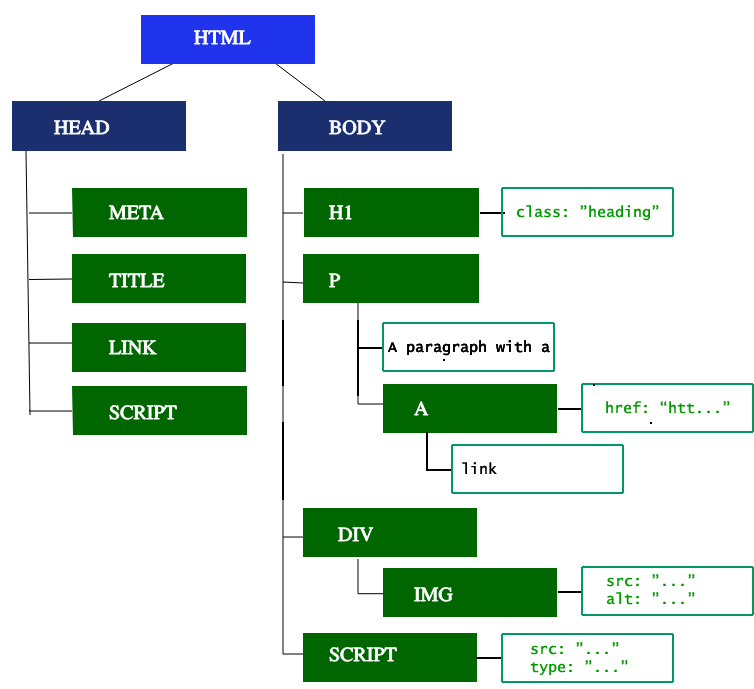
Wenn der Parser auf Ressourcen stößt, die das Parsing nicht blockieren, beispielsweise ein Bild, fordert der Browser diese an und setzt das Parsing fort. Auch beim Verarbeiten einer CSS-Datei kann das HTML-Parsing weiterlaufen. <script>-Elemente hingegen – insbesondere solche ohne async- oder defer-Attribut – blockieren das Rendering und unterbrechen das HTML-Parsing. Der Preload-Scanner des Browsers mildert zwar diese Blockierung des Renderings ab, große Skripte können aber weiterhin einen erheblichen Engpass verursachen.
Preload-Scanner
Der Aufbau des DOM-Baums beansprucht den Hauptthread. Der Preload-Scanner durchsucht die verfügbaren Inhalte und fordert Ressourcen mit hoher Priorität an, etwa CSS, JavaScript und Webfonts. Dank des Preload-Scanners müssen wir nicht warten, bis der Parser auf einen Verweis auf eine externe Ressource stößt, um diese anzufordern. Der Scanner lädt Ressourcen im Hintergrund. Wenn der eigentliche HTML-Parser die betreffenden Ressourcen erreicht, werden sie möglicherweise bereits übertragen oder sind schon heruntergeladen. Das reduziert Blockierungen.
<link rel="stylesheet" href="styles.css" />
<script src="my-script.js" async></script>
<img src="my-image.jpg" alt="image description" />
<script src="another-script.js" async></script>
Während der Hauptthread in diesem Beispiel HTML und CSS parst, findet der Preload-Scanner die Skripte und das Bild und beginnt ebenfalls mit deren Download. Das Attribut async sorgt dafür, dass das Skript den Ablauf nicht blockiert. Wenn die Reihenfolge beim Parsen und Ausführen von JavaScript wichtig ist, kann stattdessen das Attribut defer verwendet werden.
Das Warten auf CSS blockiert weder das HTML-Parsing noch Downloads. Es blockiert jedoch JavaScript, weil Skripte häufig abfragen, wie sich CSS-Eigenschaften auf Elemente auswirken.
Aufbau des CSSOM-Baums
Der zweite Schritt des kritischen Rendering-Pfads besteht darin, CSS zu verarbeiten und den CSSOM-Baum aufzubauen. Das CSS-Objektmodell ähnelt dem DOM. DOM und CSSOM sind beides Bäume, aber voneinander unabhängige Datenstrukturen. Der Browser wandelt CSS-Regeln in eine Struktur von Stilinformationen um. Diese umfasst einen Baum aus Knoten mit Eltern-, Kind- und Geschwisterbeziehungen, die sich aus den CSS-Selektoren ergeben.
Wie bei HTML wandelt der Browser die empfangenen CSS-Regeln in eine Form um, mit der er arbeiten kann. Er wiederholt also den Vorgang, mit dem HTML in Objekte umgewandelt wird, für CSS.
Der CSSOM-Baum enthält auch Stile aus dem Stylesheet des User-Agents. Der Browser beginnt mit der allgemeinsten Regel, die auf einen Knoten zutrifft, und verfeinert die berechneten Stile rekursiv, indem er spezifischere Regeln anwendet. Mit anderen Worten: Die Eigenschaftswerte werden gemäß der Kaskade bestimmt.
Der Aufbau des CSSOM geht schnell und wird in den Entwicklerwerkzeugen nicht gesondert angezeigt. Stattdessen zeigt die Metrik „Recalculate Style“ in den Entwicklerwerkzeugen die gesamte Zeit an, die benötigt wird, um CSS zu parsen, den CSSOM-Baum aufzubauen und die berechneten Stile rekursiv zu ermitteln. Bei der Performance-Optimierung lässt sich Ihre Zeit meist sinnvoller einsetzen: Der Aufbau des CSSOM dauert in der Regel weniger lang als eine einzige DNS-Abfrage.
Weitere Prozesse
JavaScript-Kompilierung
Während CSS geparst und das CSSOM erstellt wird, werden weitere Ressourcen heruntergeladen, darunter JavaScript-Dateien – dank des Preload-Scanners. JavaScript wird geparst, kompiliert und interpretiert. Die Skripte werden in abstrakte Syntaxbäume zerlegt. Einige Browser-Engines übergeben diese abstrakten Syntaxbäume an einen Compiler, der daraus Bytecode erzeugt. Dies wird als JavaScript-Kompilierung bezeichnet. Der Großteil des Codes wird auf dem Hauptthread interpretiert; Ausnahmen sind beispielsweise Programme, die in Web Workern ausgeführt werden.
Aufbau des Barrierefreiheitsbaums
Der Browser erstellt außerdem einen Barrierefreiheitsbaum, den assistive Technologien zum Erfassen und Interpretieren der Inhalte verwenden. Das Accessibility Object Model (AOM) ähnelt einer semantischen Version des DOM. Der Browser aktualisiert den Barrierefreiheitsbaum und das DOM gleichzeitig. Assistive Technologien können den Barrierefreiheitsbaum nicht direkt verändern.
Solange das AOM nicht aufgebaut ist, sind die Inhalte für Screenreader nicht zugänglich.
Rendering
Zu den Rendering-Schritten gehören die Stilberechnung, das Layout, das Zeichnen und in manchen Fällen das Compositing. Die beim Parsing erstellten CSSOM- und DOM-Bäume werden zu einem Renderbaum zusammengeführt. Anhand dieses Baums wird das Layout aller sichtbaren Elemente berechnet, die auf dem Bildschirm gezeichnet werden. In manchen Fällen können Inhalte eine eigene Ebene erhalten und per Compositing zusammengesetzt werden. Das verbessert die Performance, da Teile des Bildschirms auf der GPU statt auf der CPU gezeichnet werden und der Hauptthread entlastet wird.
Stilberechnung
Der dritte Schritt des kritischen Rendering-Pfads besteht darin, DOM und CSSOM zu einem Renderbaum zusammenzuführen. Der Aufbau dieses Baums der berechneten Stile, auch Renderbaum genannt, beginnt an der Wurzel des DOM-Baums und durchläuft jeden sichtbaren Knoten.
Elemente, die nicht angezeigt werden – etwa das Element <head> und seine Kindknoten sowie Knoten mit display: none, wie bei script { display: none; } in User-Agent-Stylesheets –, werden nicht in den Renderbaum aufgenommen, da sie nicht in der gerenderten Ausgabe erscheinen. Knoten mit visibility: hidden werden hingegen aufgenommen, weil sie Platz beanspruchen. Da wir keine Anweisungen festgelegt haben, die den Standard des User-Agents überschreiben, wird der script-Knoten aus unserem obigen Codebeispiel nicht in den Renderbaum aufgenommen.
Auf jeden sichtbaren Knoten werden seine CSSOM-Regeln angewendet. Der Renderbaum enthält alle sichtbaren Knoten samt Inhalt und berechneten Stilen: Er ordnet jedem sichtbaren Knoten des DOM-Baums die relevanten Stile zu und bestimmt anhand der CSS-Kaskade, welche Stile sich für die einzelnen Knoten ergeben.
Layout
Im vierten Schritt des kritischen Rendering-Pfads wird das Layout des Renderbaums berechnet, um die Geometrie jedes Knotens zu bestimmen. Layout bezeichnet den Vorgang, bei dem Abmessungen und Positionen aller Knoten im Renderbaum und damit Größe und Position jedes Objekts auf der Seite ermittelt werden. Als Reflow wird jede spätere Neuberechnung von Größe und Position eines Teils der Seite oder des gesamten Dokuments bezeichnet.
Sobald der Renderbaum erstellt ist, beginnt die Layout-Berechnung. Der Renderbaum gibt an, welche Knoten angezeigt werden – selbst wenn sie unsichtbar sind – und welche berechneten Stile sie haben. Abmessungen und Positionen der Knoten enthält er jedoch nicht. Um die genaue Größe und Position jedes Objekts zu bestimmen, beginnt der Browser an der Wurzel des Renderbaums und durchläuft ihn.
Auf einer Webseite ist fast alles eine Box. Unterschiedliche Geräte und Desktop-Einstellungen führen zu einer unbegrenzten Zahl verschiedener Viewport-Größen. In dieser Phase bestimmt der Browser unter Berücksichtigung der Viewport-Größe die Abmessungen aller Boxen auf dem Bildschirm. Die Layout-Berechnung beginnt üblicherweise beim Body. Dabei werden die Abmessungen aller seiner Nachfahren festgelegt und Platzhalter für ersetzte Elemente mit unbekannten Abmessungen vorgesehen, etwa für unser Bild.
Die erstmalige Bestimmung von Größe und Position jedes Knotens wird Layout genannt. Spätere Neuberechnungen des Layouts heißen Reflows. Nehmen wir in unserem Beispiel an, dass das erste Layout berechnet wird, bevor das Bild eintrifft. Da wir keine Bildabmessungen angegeben haben, kommt es zu einem Reflow, sobald diese bekannt sind.
Zeichnen
Der letzte Schritt des kritischen Rendering-Pfads besteht darin, die einzelnen Knoten auf dem Bildschirm zu zeichnen. Das erste solche Zeichnen wird als First Meaningful Paint bezeichnet. In der Zeichen- oder Rasterisierungsphase wandelt der Browser jede in der Layout-Phase berechnete Box in tatsächliche Pixel auf dem Bildschirm um. Dabei werden alle sichtbaren Bestandteile eines Elements gezeichnet, darunter Text, Farben, Rahmen, Schatten und ersetzte Elemente wie Schaltflächen und Bilder. Das muss sehr schnell geschehen.
Damit Scrollen und Animationen flüssig ablaufen, müssen alle Vorgänge auf dem Hauptthread – einschließlich Stilberechnung, Reflow und Zeichnen – in weniger als 16,67 ms abgeschlossen sein. Bei einer Auflösung von 2048 × 1536 müssen auf einem iPad über 3.145.000 Pixel auf dem Bildschirm gezeichnet werden. Das sind sehr viele Pixel, die in kürzester Zeit gezeichnet werden müssen. Damit spätere Neuzeichnungen schneller sind als das erste Zeichnen, wird die Darstellung auf dem Bildschirm in der Regel in mehrere Ebenen aufgeteilt. Dafür ist Compositing erforderlich.
Beim Zeichnen können die Elemente des Layout-Baums auf Ebenen verteilt werden. Wenn Inhalte auf der GPU eigene Ebenen erhalten, statt auf dem Hauptthread der CPU verarbeitet zu werden, verbessert das die Performance beim Zeichnen und Neuzeichnen. Bestimmte Eigenschaften und Elemente erzeugen eine eigene Ebene, darunter <video> und <canvas> sowie Elemente mit den CSS-Eigenschaften opacity, einem 3D-transform, will-change und einigen weiteren Eigenschaften. Diese Knoten und ihre Nachfahren werden auf einer eigenen Ebene gezeichnet, sofern einem Nachfahren nicht aus einem oder mehreren der genannten Gründe eine eigene Ebene zugewiesen wird.
Ebenen verbessern die Performance, verursachen aber Kosten bei der Speicherverwaltung. Im Rahmen der Web-Performance-Optimierung sollten sie daher nicht übermäßig eingesetzt werden.
Compositing
Wenn Teile des Dokuments auf verschiedenen, sich überlappenden Ebenen gezeichnet werden, sorgt das Compositing dafür, dass sie in der richtigen Reihenfolge auf dem Bildschirm erscheinen und der Inhalt korrekt gerendert wird.
Während weitere Ressourcen für die Seite geladen werden, können Reflows auftreten – denken Sie an unser Beispielbild, das erst später eintrifft. Ein Reflow löst ein erneutes Zeichnen und Compositing aus. Hätten wir die Bildabmessungen festgelegt, wäre kein Reflow erforderlich gewesen. Nur die betroffene Ebene wäre bei Bedarf neu gezeichnet und zusammengesetzt worden. Wir haben die Bildabmessungen aber nicht angegeben. Sobald das Bild vom Server geladen ist, kehrt der Rendering-Prozess deshalb zum Layout-Schritt zurück und setzt dort erneut an.
Interaktivität
Nachdem der Hauptthread die Seite gezeichnet hat, könnte man meinen, der Vorgang sei abgeschlossen. Das ist nicht unbedingt der Fall. Wenn beim Laden auch JavaScript ausgeführt werden soll, dessen Ausführung ordnungsgemäß bis nach dem Auslösen des onload-Events aufgeschoben wurde, ist der Hauptthread möglicherweise beschäftigt und steht nicht für Scrollen, Touch-Eingaben und andere Interaktionen zur Verfügung.
Die Time to Interactive (TTI) misst, wie viel Zeit von der ersten Anfrage, die zur DNS-Abfrage und TCP-Verbindung führte, bis zur Interaktivität der Seite vergangen ist. Als interaktiv gilt die Seite ab dem Zeitpunkt nach dem First Contentful Paint, an dem sie innerhalb von 50 ms auf Nutzerinteraktionen reagiert. Wenn der Hauptthread JavaScript parst, kompiliert und ausführt, ist er nicht verfügbar und kann nicht rechtzeitig – also in weniger als 50 ms – auf Nutzerinteraktionen reagieren.
Nehmen wir für unser Beispiel an, dass das Bild schnell geladen wurde, die Datei another-script.js aber 2 MB groß und die Netzwerkverbindung des Nutzers langsam ist. In diesem Fall würde der Nutzer die Seite schnell sehen, könnte aber erst dann ruckelfrei scrollen, wenn das Skript heruntergeladen, geparst und ausgeführt wurde. Das ist keine gute Nutzererfahrung. Vermeiden Sie es, den Hauptthread zu blockieren, wie dieses WebPageTest-Beispiel zeigt:
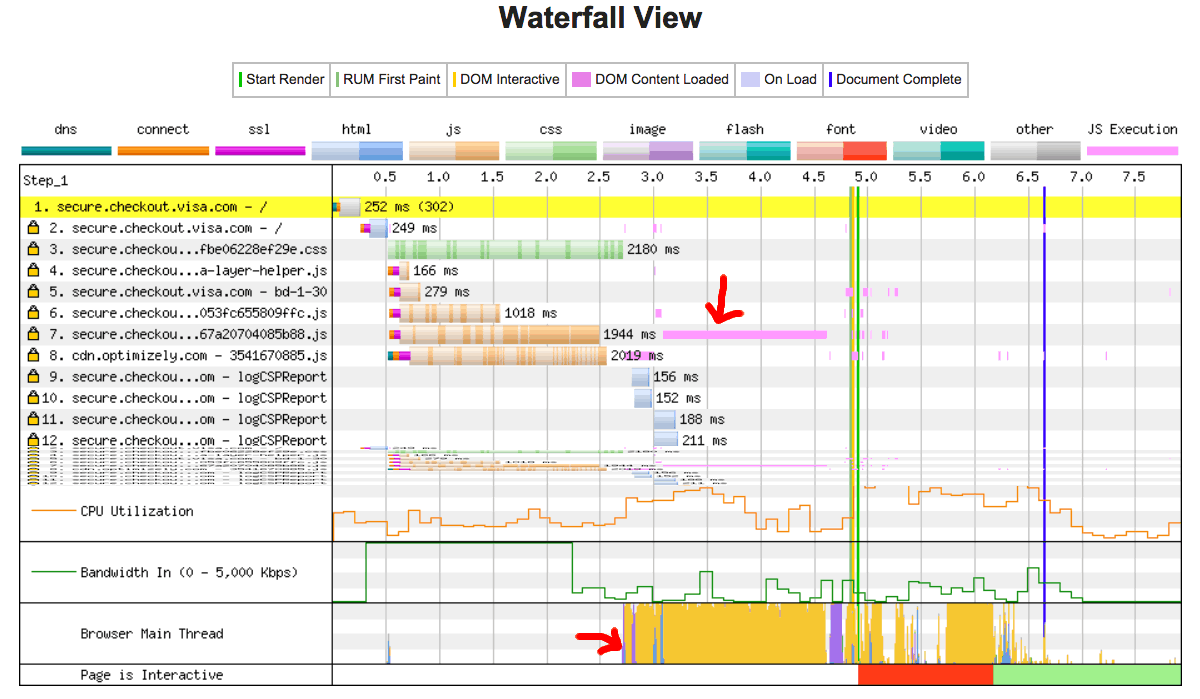
In diesem Beispiel dauerte die JavaScript-Ausführung mehr als 1,5 Sekunden. Während dieser gesamten Zeit war der Hauptthread vollständig ausgelastet und reagierte weder auf Klicks noch auf Berührungen des Bildschirms.